Incident management je postup, ktorým firma zisťuje, zaznamenáva a rieši poruchy tak, aby čo najskôr obnovila bežnú prevádzku a obmedzila škody. Hoci sa tento pojem spája najmä s IT, v zákazníckom servise pokrýva akýkoľvek nečakaný výpadok, ktorý zasiahne zákazníkov – od zásielky uviaznutej v sklade až po platobnú bránu, ktorá vypadla u dodávateľa.
Čím sa incident líši od bežnej požiadavky
Incident je situácia, keď niečo, čo predtým fungovalo, prestane fungovať alebo sa výrazne zhorší. Zákazník kvôli tomu nemôže robiť to, čo bežne robí, alebo mu hrozí škoda. Na webe nejde platobná brána, kuriérskej spoločnosti spadol systém, zásielka uviazla v sklade. Požiadavka je žiadosť o niečo nové, napríklad o duplikát faktúry, zmenu doručovacej adresy alebo používateľský účet.
Pri hraničných prípadoch pomôže otázka, či to už niekedy fungovalo. Zákazník, ktorý sa včera prihlásil a dnes nemôže, hlási incident. Kto účet ešte nemá, podáva požiadavku. Výnimkou je reklamácia chybného tovaru: služba funguje, pokazený je jeden výrobok a reklamácia má vlastný postup aj lehoty, preto ju linka vybavuje ako požiadavku.
Rozlišovať to treba, lebo incident sa rieši čo najrýchlejšie a požiadavka v bežnom poradí. Ak sa to pomieša, linka buď zbytočne hasí, alebo nechá horieť.
Väčšinu kontaktov na linke tvoria bežné požiadavky: otázky, zmeny nastavení, objednávky či reklamácie. Incidentov je menej, no zaberú neúmerne viac času aj práce. Ich podiel závisí od typu linky. Na všeobecnej zákazníckej linke tvoria zhruba 15 až 20 % kontaktov, na service desku a v technickej podpore aj 40 až 60 %.
Medzi najčastejšie incidenty patria:
- nefunkčné prihlásenie alebo zablokovaný prístup,
- chyba v aplikácii alebo zákazníckom portáli,
- nedoručený e-mail alebo dokument,
- výpadok časti systému, napríklad formulára, platobnej brány alebo upozornení,
- pomalý alebo nestabilný systém.
Technická podpora na prvej línii (L1) delí hlásenia na štyri druhy. Incident znamená, že niečo nečakane prestalo fungovať. Servisná požiadavka je plánovaná zmena, žiadosť o prístup alebo reset hesla. Známa chyba je problém, ktorý je už zdokumentovaný a má dočasné riešenie. Hromadný incident nastane, keď rovnaký problém hlási viacero používateľov.
Priorita incidentu podľa dopadu a naliehavosti
Poradie riešenia by nemal určovať ten, kto sa na linke sťažuje najhlasnejšie.
Prioritu určujú dve veci: dopad a naliehavosť. Dopad hovorí, koľkých zákazníkov sa problém týka a aká dôležitá služba nefunguje. Naliehavosť zas to, ako rýchlo sa situácia bez zásahu zhorší alebo začne spôsobovať straty.
Keď nejde platba nikomu, dopad je vysoký. Výpadok kuriérskeho systému v jednom regióne má stredný dopad a jeden zákazník, ktorý sa nevie prihlásiť, nízky. Pri nefunkčnej platbe prichádzate o objednávky každú minútu, takže naliehavosť je vysoká, kým zásielka s doručením o desať dní pokojne počká. Prioritu potom operátor vyčíta z tabuľky:
Dopad ↓ / Naliehavosť → | Vysoká | Stredná | Nízka |
Vysoký (veľa zákazníkov, hlavná služba) | P1 – kritická | P1 – kritická | P2 – vysoká |
Stredný (skupina zákazníkov, jeden región) | P1 – kritická | P2 – vysoká | P3 – bežná |
Nízky (jeden zákazník) | P2 – vysoká | P3 – bežná | P3 – bežná |
Ak si operátor nie je istý, zvolí radšej vyššiu prioritu, lebo zbytočne rýchla reakcia stojí menej ako prehliadnutý výpadok.
Na prioritu vplýva aj to, či sa dá problém obísť. Ak má zákazník funkčnú obchádzku (workaround), priorita môže klesnúť. Ak nemá žiadnu inú možnosť, stúpa. Bezpečnostný incident, napríklad únik údajov alebo neoprávnený prístup, dostane vždy najvyššiu prioritu, aj keď sa týka jediného zákazníka.
Prioritu nastavuje operátor pri prvom kontakte a zmení ju, keď sa ukáže, že incident je väčší alebo menší, ako vyzeral. Na internom service desku to funguje rovnako ako na zákazníckej linke.
Ako sa z malého hlásenia stane P1, ukazuje príklad z interného service desku. Zamestnanec hlási, že nevie vytlačiť dokument. Na prvý pohľad je to P3: týka sa jedného človeka a dokument môže poslať e-mailom.
Pri diagnostike sa však ukáže, že tlačiareň je v poriadku a neodpovedá systém na správu dokumentov, a to na celej pobočke. Ozývajú sa ďalší ľudia s rovnakým problémom, ich tickety sa spoja pod jednu príčinu a incident sa preradí na P1. Kritická služba nefunguje a stojí niekoľko oddelení.
Pri každom „malom“ hlásení sa preto oplatí overiť, či nie je súčasťou väčšieho výpadku, a až potom ho uzavrieť ako ojedinelý prípad.
Nad všetkými stupňami priority stojí ešte veľký incident (major incident). Ide napríklad o situáciu, keď e-shop spadne uprostred výpredaja a linku zaplavia stovky hovorov. Vtedy linka prejde do samostatného režimu: incident riadi koordinátor a zákazníci aj vedenie dostávajú pravidelné správy.
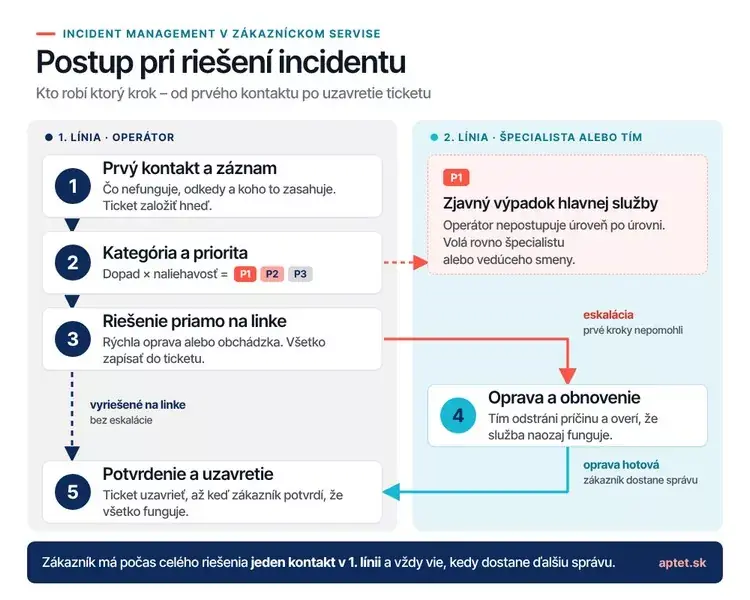
Postup pri riešení incidentu
Riešenie sa začína vo chvíli, keď sa o probléme niekto dozvie. Hotovo je až vtedy, keď služba znova funguje, zákazník o tom vie a incident je zdokumentovaný.
1. Prvý kontakt a záznam
Pri prvom kontakte operátor zisťuje, čo presne nefunguje, odkedy a ako to zákazníka obmedzuje. Popritom overuje, či ten istý problém nemajú aj ďalší ľudia. S vetou „nejde mi to“ sa rozhovor iba začína.
Pri technickom hlásení pomôže pevné poradie otázok: Čo presne nefunguje? Odkedy? Na akom zariadení alebo účte? Objavuje sa chybové hlásenie alebo kód chyby? Má zákazník snímku obrazovky? Zmenilo sa niečo tesne pred poruchou, napríklad aktualizácia alebo nastavenia? Z odpovedí má vzniknúť opis, podľa ktorého chybu zopakuje a vyrieši aj kolega, ktorý pri hovore nebol.
Potom operátor založí ticket s vlastným číslom.
Do záznamu patrí:
- kto problém nahlásil a ako ho kontaktovať,
- čo nefunguje, aj s presným znením chybového hlásenia,
- odkedy problém trvá a koho alebo čo zasahuje (služba, objednávka, región),
- čo sa už skúšalo a s akým výsledkom,
- kto ticket práve rieši a kedy dostane zákazník ďalšiu správu.
V ticketoch najčastejšie chýba kontakt, cez ktorý sa dá zákazníkovi ozvať, a presné znenie chyby aj s časom, keď sa objavila. Často v nich nie je ani to, čo sa zmenilo pred poruchou a či problém niekto skúšal na inom zariadení alebo účte.
Ticket treba založiť hneď, aj keď ešte nie je všetko jasné. Na prácu potom môže nadviazať ktokoľvek a zákazník nemusí nič vysvetľovať odznova.
2. Kategória a priorita
Operátor zaradí incident do kategórie (platby, doručenie, prihlásenie…) a podľa tabuľky vyššie mu určí prioritu. Zaradenie pôsobí ako formalita, no bez neho o mesiac nezistíte, ktoré problémy sa vracajú.
3. Riešenie priamo na linke
Ak sa dá, operátor problém vyrieši hneď. Skontroluje nastavenia a údaje, zopakuje krok, ktorý zlyhal, alebo siahne po návode na podobný prípad. Príčinu nie vždy dokáže odstrániť, vtedy môže zákazníkovi ponúknuť bezpečné dočasné riešenie, napríklad iný spôsob platby. Všetko, čo skúsil, zapíše do ticketu aj s výsledkom. Ak prvé kroky nepomohli, operátor incident eskaluje. Kedy a ako, opisuje časť o eskalácii.
Najčastejšie dočasné riešenia (obchádzky) sú jednoduché: reštart aplikácie alebo nové prihlásenie, iný kanál (e-mail namiesto portálu), iné zariadenie či prehliadač, ručné spracovanie namiesto automatického alebo dočasne vyššie oprávnenia podľa schváleného postupu. Obchádzku operátor zapíše do ticketu zvlášť, aby si ju nikto nepomýlil s trvalou opravou.
4. Oprava a obnovenie prevádzky
Príčinu hľadá a opravuje tím, ktorý za danú oblasť zodpovedá. Potom overí, či služba naozaj funguje, a do ticketu zapíše, čo urobil. Uvedie aj to, či ide o trvalú opravu. Ak chybu len obišiel a príčina pretrváva, založí sa na ňu samostatný záznam. V ITIL sa mu hovorí problém a stará sa oň problem management.
5. Potvrdenie a uzavretie
To, že oprava funguje technikom, ešte neznamená, že funguje aj zákazníkovi. Incident sa preto najprv označí ako vyriešený a zákazník dostane správu.
Ticket operátor uzavrie až vtedy, keď zákazník potvrdí, že všetko funguje. Ak na výzvu nereaguje, ticket sa po dohodnutom čase zatvorí automaticky, zvyčajne po troch až piatich pracovných dňoch od poslednej výzvy. O tomto pravidle musí zákazník vedieť vopred. Keď sa ticket zatvorí bez overenia, zákazník sa často ozve znova. Preto sa sleduje aj počet znova otvorených ticketov.
Ako rozpoznať, že 30 telefonátov je jeden incident
Za polhodinu zavolá 30 ľudí, že im nejde platba kartou. Zakladať 30 samostatných incidentov a posielať ich technikom jeden po druhom nemá zmysel. Operátor by si mal všimnúť, že ide stále o tú istú službu, ľudia opisujú podobné ťažkosti a všetko sa začalo približne v rovnakom čase.
Ak sa spoločný výpadok potvrdí, založí sa jeden hromadný incident a tickety zákazníkov sa k nemu pripoja. Bežné nástroje podpory to zvládajú. Po oprave hneď viete, koho informovať, a z počtu pripojených ticketov si urobíte predstavu o skutočnom rozsahu výpadku. Či ide aj o veľký incident, rozhoduje dopad, nie samotné množstvo hovorov.
Podobné hlásenia však ešte nemusia mať spoločnú príčinu. Môže sa stať, že každý zákazník má s platbou iný problém. Vtedy ide o samostatné incidenty, a preto si operátor spoločné znaky najprv overí s technickým tímom.
Kedy a komu incident eskalovať
Eskalácia najčastejšie zlyhá pri odovzdaní: nikto presne nevie, kto ticket drží, dokedy ho má vyriešiť a čo sa už skúšalo. Preto má byť vopred jasné, kto čo robí.
Úroveň | Kto | Čo robí |
1. línia | operátor | prijme hlásenie, zapíše ho, určí prioritu, skúsi jednoduché riešenie |
2. línia | špecialista alebo tím (technická podpora, správca systému, logistika, dodávateľ) | zistí príčinu a opraví ju |
Vedenie | vedúci smeny, incident manažér | rozhoduje, zháňa ľudí, vyhlasuje veľký incident, informuje vedenie a dôležitých zákazníkov |
Aj keď problém opravuje niekto iný, zákazník je počas celého riešenia v kontakte s jedným človekom z prvej línie. Pri hromadnom incidente komunikáciu so všetkými dotknutými zákazníkmi koordinuje určená osoba, zvyčajne vedúci smeny.
Kedy operátor incident posunie ďalej
Operátor si incident nechá, ak problém pozná, má naň návod aj oprávnenia a stihne ho v čase vyhradenom pre prvú líniu. Ak sa za ten čas nič nepohne, ďalšie skúšanie väčšinou nepomôže. Odovzdať by ho mal, keď:
- mu chýbajú znalosti alebo prístup do systému,
- prvé kroky nepomohli alebo sa problém po oprave vrátil,
- sa blíži koniec dohodnutej lehoty a riešenie nie je na dohľad,
- prichádzajú podobné hlásenia a môže za nimi byť spoločná príčina,
- treba rozhodnúť o niečom, na čo nemá právomoc, povedzme o kompenzácii alebo výnimke.
Pri P1, napríklad pri zjavnom výpadku hlavnej služby, operátor nepostupuje úroveň po úrovni a volá rovno špecialistu alebo vedúceho smeny.
Ak vedenie berie eskaláciu ako zlyhanie, operátori začnú držať tickety, ktoré mali dávno posunúť. Ak sa naopak posiela ďalej všetko, špecialisti sa utopia v jednoduchých hláseniach. Krátky zoznam kritérií, ako je ten vyššie, funguje lepšie ako rozhodovanie podľa pocitu.
Odborná a riadiaca eskalácia
ITIL rozlišuje dva smery eskalácie. Odborná (funkčná) smeruje k špecialistovi, ktorý vie problém opraviť. Riadiaca (hierarchická) ide k vedúcemu, ktorý môže rozhodnúť, pridať ľudí alebo informovať vedenie. Pri vážnom incidente bežia obe súčasne.
Časové limity, aby ticket nekoloval
Ticket začne kolovať medzi oddeleniami vo chvíli, keď nikto nevie, čo sa s ním deje. Proti tomu pomáhajú dve lehoty pre každú úroveň: dokedy ticket niekto prevezme a dokedy bude hotový výsledok. Po uplynutí termínu ho systém posunie ďalej sám. Pri P1 to môže byť prevzatie do 15 minút a potom automatický posun k vedúcemu.
Lehoty nastavte tak, aby sa dali reálne dodržať. Pri tickete má byť vždy meno konkrétneho človeka, samotný názov tímu nestačí. Kto ticket vracia, napíše dôvod.
Ako odovzdať incident, aby sa zákazník nemusel opakovať
Ak musí zákazník to isté vysvetľovať druhýkrát, chyba je v odovzdaní. Navrchu ticketu majú byť dve až tri vety o tom, o čo ide, čo sa už urobilo a čo treba spraviť teraz.
Môže to vyzerať takto:
Platba kartou nefunguje viacerým zákazníkom približne od 13:40, prvé hlásenie 13:52. Chyba „transakcia zamietnutá“, pripojených 12 ticketov. Overené: nejde o kartu zákazníka (skúšané 3 rôzne). Obchádzka: žiadna. Priorita P1. Zákazníkom oznámené, že sa to rieši, ďalšia správa do 14:30. Vlastník: Marek H. (technický tím), komunikáciu so zákazníkmi koordinuje Jana P. (vedúca smeny).
Technické poznámky zostávajú interné. Zákazník dostane zrozumiteľnú správu a čas, kedy sa mu znova ozvete. Dobre napísaný záznam umožní kolegovi pokračovať bez jedinej otázky na zákazníka.
Komunikácia so zákazníkmi počas výpadku
Linka sa pri výpadku rozzvoní skôr, než technici vôbec zistia, čo sa stalo. Volajúceho v tej chvíli príčina až tak nezaujíma. Chce počuť, že o probléme viete a kedy sa mu ozvete.
Prvú správu pošlite čo najskôr. PagerDuty vo svojom postupe počíta s piatimi minútami od začiatku riešenia. Stačí v nej potvrdiť problém, stručne napísať, koho sa týka, a sľúbiť ďalšiu správu. Čas opravy si nevymýšľajte, lebo nesplnený termín poškodí dôveru viac ako úprimné „zatiaľ nevieme“.
Potom posielajte správy pravidelne. PagerDuty odporúča v prvých dvoch hodinách aspoň každých 20 minút, Atlassian každých 30 minút. Na presnom intervale až tak nezáleží. Dôležitejšie je, aby každá správa uviedla čas tej ďalšej a aby ste ho dodržali, aj keď nemáte čo nové povedať. Web, e-mail, sociálne siete aj hláška na linke musia hovoriť to isté. Ak banner na stránke tvrdí niečo iné ako operátor, ľudia budú volať znova.
Aj keď výpadok spôsobil dodávateľ, zákazník to vidí ako problém vašej služby. Ospravedlňte sa však len tým, ktorí o ňom vedia. Výskum publikovaný v Journal of Consumer Research zistil, že keď sa firma ospravedlní ľuďom, ktorí o chybe vôbec nevedeli, ich spokojnosť aj dôvera klesnú.
Ani kompenzácia nenahradí rýchlu a slušnú reakciu. Podľa štúdie Wirtza a Mattilovej pomáha, keď zlyhala jedna z dvoch vecí: riešenie meškalo, alebo chýbalo ospravedlnenie. Keď zlyhali obe, kompenzácia nespokojnosť nezmierni.
Keď je linka zahltená
Keď výpadok zasiahne zákazníkov, hovorov býva trikrát až desaťkrát viac ako v bežný deň. Nápor začne, len čo si prví ľudia problém všimnú, a vrcholí v prvej polhodine až hodine.
Automatickú hlášku zapnete za pár minút. Stačí ju nastaviť v hlasovom menu (IVR), čo zvládne tím telefónie alebo supervízor s potrebným oprávnením.
S ľuďmi to ide pomalšie. Zapojiť trénerov, supervízorov kvality alebo kolegov z iných oddelení trvá 15 až 60 minút podľa toho, kto je k dispozícii a koľko ho treba zaškoliť. Posila z inej pobočky alebo od externého partnera dorazí až o niekoľko hodín.
Kým posila dorazí, vrchol náporu často pominie. Prvú vlnu hovorov preto musí zachytiť automatika.
Na začiatok hovoru zaraďte automatickú hlášku, ktorá výpadok potvrdí a odkáže na web. Mnohí sa dozvedia, čo potrebovali, a zložia. Ostatným namiesto čakania v rade ponúknite spätné volanie. A ak nápor pravidelne prerastá kapacitu vášho tímu, časť hovorov môže prebrať externá linka s operátormi na špičky.
Keď operátori počas výpadku nevedia požiadavku vybaviť, mali by všetci hovoriť to isté. Napríklad: „Máme technickú poruchu a už ju riešime. Vašu objednávku teraz v systéme neoverím. Ak chcete, zapíšem si vaše číslo a ozveme sa vám, len čo systém znova pobeží. Alebo nám, prosím, zavolajte neskôr.“ Čas opravy operátor nesľubuje, kým ho nepotvrdí technický tím.
Rozbor po incidente
O tom, či sa ten istý problém o mesiac vráti, rozhoduje až to, čo urobíte po oprave. Pri závažných incidentoch si preto nájdite čas na krátky rozbor. Google v príručke SRE odporúča sústrediť sa pri ňom na príčiny a vinníka nehľadať, pretože kto čaká trest, zamlčí podstatné.
Stačia štyri otázky: čo sa stalo a kedy, ako sa o tom tím dozvedel, čo pomohlo a čo zdržalo. Aj formulácie majú byť vecné: namiesto „operátor zabudol skontrolovať“ napíšte do zápisu „postup neobsahoval kontrolu“.
Z rozboru majú vzniknúť konkrétne úlohy, každá s menom a termínom. Pod bodom „zlepšiť kontrolu platieb“ si každý predstaví niečo iné. „Nastaviť upozornenie, keď počet zamietnutých platieb prekročí bežnú hodnotu“ je jasné zadanie.
Riešenie zapíšte aj do znalostnej bázy. Consortium for Service Innovation na to má metodiku Knowledge-Centered Service, pri ktorej sa znalosti zapisujú priebežne počas práce na ticketoch. Firmy, ktoré ju zavedú, podľa konzorcia skrátia čas riešenia o 25 až 50 % už za 3 až 9 mesiacov a znížia počet eskalácií.
Stačí sledovať pár čísel. Základom je čas prvej reakcie a čas vyriešenia. K nim pridajte podiel eskalácií. Keď rastie, býva za tým zastaraný návod, slabé zaškolenie alebo nejasné kritériá.
Veľa znova otvorených ticketov zas prezrádza, že sa uzatvárajú predčasne alebo opravy nie sú úplné. Posledným ukazovateľom je spokojnosť zákazníka po uzavretí ticketu.
Čísla treba čítať spolu. Ak sa tickety riešia rýchlo, ale mnohé z nich sa znova otvárajú, opravuje sa narýchlo. Porovnávajte ich hlavne s vlastnými výsledkami z minulých mesiacov, cudzie tabuľky vám toho veľa nepovedia.
Čo má obsahovať incidentný plán
Počas výpadku nie je čas dohadovať sa, kto čo robí. Plán je preto lepšie pripraviť v pokoji. Mal by pokryť:
- roly: kto incident vedie (veliteľ incidentu sám nič neopravuje, len rozdeľuje prácu), kto komunikuje so zákazníkmi a kto s vedením, kto zapisuje časovú os a kto koho zastúpi,
- kontakty na technika, platobnú bránu, hosting, dopravcu a službu mimo pracovného času,
- šablóny správ „riešime“, „poznáme príčinu“ a „opravené“ pre linku, web aj e-mail a pri každom kanáli meno človeka, ktorý doň píše,
- eskalačné cesty: kto je prvý, druhý a tretí v poradí, po koľkých minútach sa ide ďalej a kto smie vyhlásiť veľký incident.
Malému tímu, ktorý má pár hlásení týždenne, stačí zdieľaná tabuľka. Keď však pribudnú ľudia, kanály a lehoty, tabuľka prestane stačiť, lebo sama nikoho neupozorní a incident ďalej neposunie. Kedy prejsť na ticketovací systém a čo by mal vedieť, nájdete v článku o ticketovacích systémoch.
Kedy sa oplatí dať zákaznícky servis externej firme
Externý servis má zmysel najmä vtedy, keď výpadky prichádzajú aj večer a cez víkend, ale váš tím pracuje len cez deň. Pomôže aj vtedy, keď pri náraze hovorov nemáte koho pridať na linku. A potom sú tu sezónne špičky, ktoré prídu párkrát do roka a kvôli ktorým sa neoplatí platiť ľudí navyše.
Celý servis pritom nemusíte zveriť externej firme. Spolupráca môže pokryť jediný kanál, napríklad e-mail, ale aj celé call centrum, ktoré nepretržite obsluhuje telefón, chat a sociálne siete. Niektorí odovzdajú partnerovi, ktorý prevádzkuje externý zákaznícky servis pre menšie firmy, len sezónny nápor a eskalácie si nechajú vo vlastnom tíme.
Na sezónny nápor sa dá pripraviť tromi spôsobmi. Vlastný tím posilníte do jedného až dvoch dní: predĺžite zmeny, pridáte nadčasy alebo odložíte školenia a individuálne stretnutia.
Nabrať a zaškoliť nových ľudí aspoň na základnú agendu trvá pri dobre pripravenom programe najmenej dva až štyri týždne. Presunúť časť kontaktov na iný tím alebo k externému partnerovi sa dá rýchlejšie, ak máte zmluvu a podklady na zaškolenie pripravené vopred.
Sezónne špičky sa dajú predvídať. Čísla z minulých rokov, kalendár kampaní a nástroj na plánovanie zmien (WFM) stačia na to, aby ste kapacitu naplánovali niekoľko týždňov dopredu. Zháňať ľudí na poslednú chvíľu je vždy drahšie a výsledok býva horší.
Keď si firma vyberie externého partnera, stane sa jeho klientom a spolupráca sa začne odovzdaním podkladov. Najlepšie podľa zoznamu, na ktorom sa obe strany dohodnú ešte pred spustením.
Mal by obsahovať aspoň:
- schválené odpovede a články znalostnej bázy,
- kategórie a povinné polia v ticketovacom systéme,
- eskalačnú maticu s kontaktmi,
- pravidlá overovania identity,
- lehoty (SLA) pre jednotlivé typy požiadaviek,
- krízové a incidentné scenáre,
- pravidlá ochrany údajov.
Bez nich operátori prvé dni improvizujú, robia viac chýb a zákazníci volajú opakovane.
Pri štarte novej zákazky najčastejšie chýbajú:
- Menný zoznam ľudí na strane klienta s telefónmi a rozdelením zodpovednosti. Operátor musí vedieť, kto schvaľuje výnimky, kto rieši technickú eskaláciu a kto posiela oficiálne vyjadrenia zákazníkom.
- Hotové odpovede. Klient má produktovú dokumentáciu, ale nie vety, ktoré môže operátor zákazníkovi rovno povedať. Každý potom odpovedá po svojom a zákazníci dostávajú rôzne informácie.
- Kategórie, štítky a povinné polia pre externý tím. Klient síce má vlastný systém, no bez nich sú záznamy neúplné od prvého dňa.
- Pravidlá ochrany údajov práve pre tohto klienta. Všeobecný rámec GDPR býva spísaný, ale to, čo nesmie byť v tickete a ako overovať identitu, sa vyjasňuje až pri prvých skutočných prípadoch.
- Krízové scenáre. Postup pri výpadku, pri chybne poskytnutej informácii alebo pri sťažnosti s právnymi následkami je dohodnutý len v hrubých rysoch.
Tieto medzery sa zvyčajne zaplátajú počas prvých dvoch až štyroch týždňov prevádzky, keď prídu prípady, na ktoré pri zaškolení nikto nemyslel. Lepšie je im predísť.
Pred spustením si spolu s partnerom prejdite aspoň 10 až 15 modelových situácií vrátane krízových a pri každej si overte, či k nej existuje schválená odpoveď, potrebné oprávnenie a jasná eskalačná cesta.
Externí operátori vedia len to, čo im odovzdáte. Incidentný plán, šablóny správ a kontakty preto potrebujú hneď od prvého dňa.
Zdroje:
https://response.pagerduty.com/during/external_communication_guidelines/
https://support.atlassian.com/statuspage/docs/incident-communication-tips
https://cleanfax.com/are-apologies-for-a-service-failure-always-the-best-policy/
https://www.emeraldinsight.com/doi/abs/10.1108/09564230410532484
https://www.atlassian.com/blog/statuspage/how-to-create-an-incident-communication-plan
https://response.pagerduty.com/before/different_roles/
https://docs.octopus-itsm.com/en/node/678
https://www.atlassian.com/incident-management/itsm
https://itglue.com/blog/topic/it-glue-library
https://blog.invgate.com/service-desk-sop-for-incident-escalation
https://medium.com/@hemant.panda9/itil-incident-vs-service-request-part-2-a4e770055c64
https://sre.google/sre-book/postmortem-culture/
https://www.atlassian.com/incident-management/handbook/postmortems
https://blog.invgate.com/incident-management-metrics
https://www.topdesk.com/en/?p=29835
https://www.kustomer.com/glossary/customer-support-outsourcing/
Začnite písať sem...